Diccionario RAE Completo

He decidido dar por concluida la ordenación del Diccionario de la RAE, que me descargué con el programa buscaenrae.sh y el programa descargarae.sh hecho para la ocasión y que leía el archivo con la lista de palabras (al que impropiamente denominaba diccionario), para descargar, una a una, las páginas correspondientes.

Todo partió del trabajo que realicé para el proyecto del Diccionario Personal de Isidoro Valcárcel Medina, en 2015.

Ahí nos encontramos con la negativa de la RAE a ceder el diccionario en modo digital, así que tuve que teclear las entradas del mismo a lo largo de más de 3 meses. Finalmente, acabé teniendo una lista de 90940 palabras, algunas de las cuales eran acepciones repetidas. Si quitábamos las palabras que tenían más de una acepción y que estaban en el archivo etiquetadas con un número 1,2,… según procediera, nos quedaban 88296 palabras (debería llamarlas «entradas»).

Por supuesto, estaban plagadas de errores:

  1. En primer lugar los propios de tecleo.
  2. En segundo lugar (oh, my god!) tenía incluidas en mi colección las palabras que Isidoro había decidido incluir en su diccionario personal independientemente de las que hubiera en el de la RAE.
  3. En tercer lugar (y esto resultó ser lo peor), muchas palabras han «desaparecido», pues la entrada no corresponde a la palabra… por ejemplo, la palabra «poeta, tisa», no está en el diccionario sino en «poetisa», así que la palabra poeta no se encuentra en la RAE como tal.

Así que el programa contemplaba la necesidad de decirme si tal o cual palabra no estaba en el diccionario de la RAE (en la versión online)

Actualización 2020
La Real Academia Española (RAE) y la Asociación de Academias de la Lengua Española (ASALE) han emprendido ya las tareas de redacción de la nueva edición de su Diccionario de la lengua española (DLE), que tendrá las características fijadas en la planta aprobada por todas las Academias de ASALE. Con el objetivo de que el desarrollo de esa nueva edición, forzosamente lento, no retrase la inclusión de nuevas palabras y acepciones ni la modificación de las ya incorporadas que necesiten enmienda, se ha optado por publicar estas actualizaciones anualmente.

La que ahora se pone a disposición de todas las personas interesadas recoge las modificaciones aprobadas por todas las Academias en 2020 y tendrá la consideración de versión electrónica 23.4.

Ya de paso, como podía hacerlo, me informé de si la palabra que estaba consultando era o no conjugada, lo que significaba que era un verbo. Un bonito plus que no esperaba.

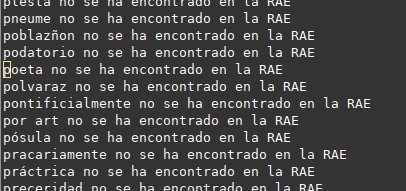
Con la lista de errores generada, fui revisándolas palabra a palabra, las 1245 entradas no encontradas, entre las que estaban, ni más ni menos: poeta.
Así que a lo largo de los últimos meses del 2020 fui dejándome los ojos para ir revisando esos errores y fabricando una lista de palabras que se corresponda lo más posible con la «oficial» de la RAE.

Ha quedado una lista de 88024 «entradas» que se corresponden con 90452 palabras (ya teniendo en cuenta que algunas entradas o vocablos tienen varias palabras (a veces me confundo y denomino a eso acepciones).

Una vez corregida y revisada, aunque asumo aún un error considerable que no puedo prever, tengo la posibilidad de descargar el diccionario completo palabra a palabra con el programa buscaenrae.sh


#!/bin/bash

### FUNCIONES ÚTILES PARA EL PROGRAMA
# uso() Instrucciones del programa y salida en caso de error.
uso () {
  echo "Uso: $0 salida palabra"
  echo -e "\tsalida es un valor númerico que identifica:"
    echo -e "\t[0] para generar un archivo HTML con la respuesta"
    echo -e "\t[1] para generar un archivo TXT  con la respuesta"
    echo -e "\t[2] para generar una línea  TXT  con la respuesta"
  exit
}
f_verbos="00000_VERBOS.txt"
f_errores="00000_ERRORES.txt"

# CONTROL DE ENTRADA DE VARIABLES y ASIGNACIÓN
if [ $# -lt 2 ]
then
  # Reportar uso inapropiado
  uso
else
  salida=$1
  if [ $# -eq 2 ]; then
    palabra="$2"
  elif [ $# -eq 3 ]; then 
    palabra="$2 $3"
  elif [ $# -eq 4 ]; then 
    palabra="$2 $3 $4"
  elif [ $# -eq 5 ]; then 
    palabra="$2 $3 $4 $5"
  fi
  # echo "Palabra es #$palabra#"
fi

# CONSULTA DEL SERVIDOR de la RAE simulando ser uno de los diversos navegadores posibles
navegador=(
  "Mozilla/5.0 (X11; Ubuntu; Linux x86_64; rv:15.0) Gecko/20100101 Firefox/15.0.1"
  "Mozilla/5.0 (Windows NT 10.0; WOW64; rv:77.0) Gecko/20100101 Firefox/77.0"
  "Mozilla/5.0 (Windows NT 6.1; WOW64; rv:77.0) Gecko/20190101 Firefox/77.0"
  "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_9_3) AppleWebKit/537.75.14 (KHTML, like Gecko) Version/7.0.3 Safari/7046A194A"
)
rnd=`echo $(($RANDOM%${#navegador[@]}))` # Elegimos un navegador al azar
# Hacemos la petición a la web de la RAE
curl -s --user-agent "${navegador[$rnd]}" https://dle.rae.es/"$palabra" > ./"$palabra.html"

# PROCESAMOS EL ARCHIVO OBTENIDO (Cortamos, retiramos lo innecesario, etc)
# Si se trata de un verbo, quitar las conjugaciones
id_conjugacion="<div id='conjugacion'>"
esunverbo=`grep -c "$id_conjugacion" ./"$palabra.html"`
if [ $esunverbo -gt 0 ]
then
  echo "$palabra es un verbo" >> $f_verbos
  # ELIMINAMOS la(s) CONJUGACIÓN(ES)
  sed -i "/${id_conjugacion}/d" ./"$palabra.html"
fi

# Si tiene más de una acepción (Calcular cuántas después de saber si es un verbo)
id_acepcion="<article id="
id_acepcion_fin="<\/article>"
num_acepciones=`grep -c "$id_acepcion" ./"$palabra.html"`
# Si no tiene acepciones, la palabra no existe. No continuamos.
if [ $num_acepciones -eq 0 ]
then
  echo "$palabra no se ha encontrado en la RAE" >> $f_errores
  rm "./$palabra.html"
  exit
fi

# PARTIR en $num_acepciones EL FICHERO $palabra.html"
# acepciones y acepciones_fin son 2 arrays de líneas PRECISO CONVERTIRLOS a cortes[]
acepciones=`grep -n "$id_acepcion" ./"$palabra.html"|awk -F":" '{print $1}'|sed ':a;N;$!ba;s/\n/ /g'`
c=0
for i in $acepciones
do
  let cortes[$c]=$(($i))
  let c=$(($c+1))
done
acepciones_fin=`grep -n "$id_acepcion_fin" ./"$palabra.html"|awk -F":" '{print $1}'|sed ':a;N;$!ba;s/\n/ /g'`
c=0
for i in $acepciones_fin
do
  let cortes_fin[$c]=$(($i))
  let c=$(($c+1))
done

# GENERA FICHEROS palabra.X.html por cada ACEPCIÓN
for (( i=0; i<$num_acepciones; i++ ))
do
  # echo "El comienzo del corte está en ${cortes[$((i))]}"
  # echo "El fin del corte está en ${cortes_fin[$((i))]}"
  sed "${cortes[$((i))]},${cortes_fin[$((i))]} !d" "./$palabra.html" > "./$palabra.$i.html"
  # Distintas salidas del programa, en función de la variable "salida"
  if [ $salida -gt 0 ]   # Salida a modo TXT
  then
    w3m "./$palabra.$i.html" > "./$palabra.$i.txt"
    if [ $salida -gt 1 ] # En una sóla línea
    then
      sed ':a;N;$!ba;s/\n/ /g' "./$palabra.$i.txt"|sed 's/  / /g' > "./$palabra.$i.1linea"
    fi
  fi
done

# BORRAR indica si dejar o no los archivos que no se deseen como salida 
BORRAR=1
if [[ $BORRAR -eq 1 ]] && [[ $salida -gt 0 ]]
then
  rm "./$palabra."*html
  if [ $salida -eq 2 ]
  then
    rm "./$palabra."*txt
  fi
fi
# SALIDA FORZADA
exit


Este programa era invocado con el siguiente miniprogramita que, leyendo de la lista de palabras corregidas que, impropiamente, denominé diccionariosinrepes.txt, obtiene las diversas, impropiamente denominadas, acepciones y las separa en 90452 archivos de una única línea.

#!/bin/bash

### FUNCIONES ÚTILES PARA EL PROGRAMA
# uso() Instrucciones del programa y salida en caso de error.
uso () {
  echo "Uso: $0 [diccionario]"
  exit
}

# CONTROL DE ENTRADA DE VARIABLES y ASIGNACIÓN
if [ $# -gt 1 ]
then
  # Reportar uso inapropiado
  uso
elif [ $# -eq 1 ]
then
  diccionario=$1
else
  diccionario=diccionariosinrepes.txt
fi

while IFS= read -r line
do
  buscaenrae.sh 2 $line
done < $diccionario

Descargadas y archivadas en una estructura de carpetas obvia:

dict -> LETRA

Se pueden reordenar o «recompilar» en una LETRA, con sus definiciones incluidas, sin incluir, etc…

Lo hago usando otro script simple:

#!/bin/bash

# El diccionario completo está por acepciones en las carpetas
# dict/LETRA
# Cada acepción (en realidad entrada en el diccionario) tiene
# un archivo denominado PALABRA.N.1linea conteniendo su definición.
# (donde N es el número de acepción contando desde cero)

letras="A B C D E F G H I J K L M N Ñ O P Q R S T U V W X Y Z"
for letra in $letras
do
  ls dict/$letra > dictporletra/$letra.archivos.txt
  awk -F"." '{print $1}' dictporletra/$letra.archivos.txt > dictporletra/$letra.acepciones.txt
  ls dict/$letra/*.0.1linea |awk -F"/" '{print $3}'|awk -F"." '{print $1}' > dictporletra/$letra.sinrepes.txt
  cat dict/$letra/* > dictporletra/$letra.definiciones.txt
done

cat dictporletra/*.archivos.txt > DICCIONARIO_TOTAL.archivos.txt
cat dictporletra/*.acepciones.txt > DICCIONARIO_TOTAL.acepciones.txt
cat dictporletra/*.sinrepes.txt > DICCIONARIO_TOTAL.sinrepes.txt
cat dictporletra/*.definiciones.txt > DICCIONARIO_TOTAL.definiciones.txt

Pero queda por resolver un problema que me tiene algo martirizado desde hace meses y es que la ordenación es muy compleja realizarla, pues muchas entradas en el diccionario son dobles, como «ad hoc», pero las definiciones descargadas incluyen líneas que son del tipo: «i Escrito con…» y desde el punto de vista del uso del comando sort, es más o menos lo mismo que decir que si quiero ordenar las primeras como «adhoc», la «iEscrito» se sale de su lugar.

He ordenado muchas manualmente sobre esta compilación, pero es un trabajo absolutamente aberrante y seguro que se puede hacer mejor, así que de momento he decidido dejar de trabajar en esto y dar por cerrado este proyecto que, en realidad, es la puerta de entrada a muchos otros.

Espero que el orden no sea algo tan terrible en esos otros proyectos venideros.

Dejo a disposición pública el Diccionario Completo que he generado de esta manera, con la estructura de carpetas generada, así como los programas utilizados para su procesamiento.
RAE-COMPLETO.tar

75% de despojos

de repente un día mueres

deja un 75% de despojos.

tres primeras sílabas
para decir lo obvio:
de la vida a la muerte
hay
un salto cuántico
un salto cualitativo
un salto irreversible

no puede ser de otro modo
tal como están definidas ambas palabras
en ese lenguaje
de lógica bivalente
tan binario
que garantiza principio del tercero excluso
tertium non datur

tres primeras sílabas
ejercitando oulipianamente
su apego a la única vocal
que Perec secuestra

tres segundas sílabas
que no lo parecen
por aquella sinalefa que ha sido ignorada
por aquel hiato que rompe el diptongo
por la preponderancia de vocales diferentes
que alcanza el 60%
de tan sólo (con tilde) cinco letras

tres segundas sílabas
que sitúan en el tiempo
absolutamente indefinido (en cuanto a cuándo
(¿qué día?)
absolutamente indefinido (en cuanto a cuánto
(¿día sidéreo o día solar?)

un suceso
que podemos calificar con once letras como
un suceso inacabable
un suceso inagotable
un suceso inapagable
un suceso inapelable
un suceso inatacable
un suceso inatajable
un suceso incachable
un suceso incalmable
un suceso incansable
un suceso incantable
un suceso incobrable
un suceso incontable
un suceso inculpable
un suceso indeseable
un suceso inevitable
un suceso inexorable
un suceso inexpiable
un suceso infaltable
un suceso inflamable
un suceso inglosable
un suceso ingustable
un suceso inhallable
un suceso inimitable
un suceso injertable
un suceso inllevable
un suceso inmancable
un suceso inoperable
un suceso inopinable
un suceso inoxidable
un suceso insaciable
un suceso insalvable
un suceso insociable
un suceso insoldable
un suceso insondable
un suceso intachable
un suceso integrable
un suceso intragable
un suceso intratable
un suceso intricable
un suceso inubicable
un suceso invadeable
un suceso invaluable
un suceso invariable
un suceso inviolable
un suceso inyectable

 
hasta que llegas al mismo
término
a esa segunda persona
que te asusta
porque asusta a otro
que somos yo

esas dos llanas sílabas
de las ocho iniciales
que son el despojo
que no son el despojo
que son la enjundia
el non plus ultra
el meollo de la frase
lo verdaderamente importante
y a lo que no quieres llegar
por lo que te amparas en otras seis
previas unidades silábicas
que te conducen
inexorablemente
al fin

Errores

Yo al periodismo ya le pido poco en término de revisión de errores y comprendo (cada día soy más comprensivo, casi compresivo) sus habituales deslices por la premura con la que generan las noticias cada menos de 2 horas (son llamados diarios, pero alguna vez habrá que rebautizarlos como horarios).

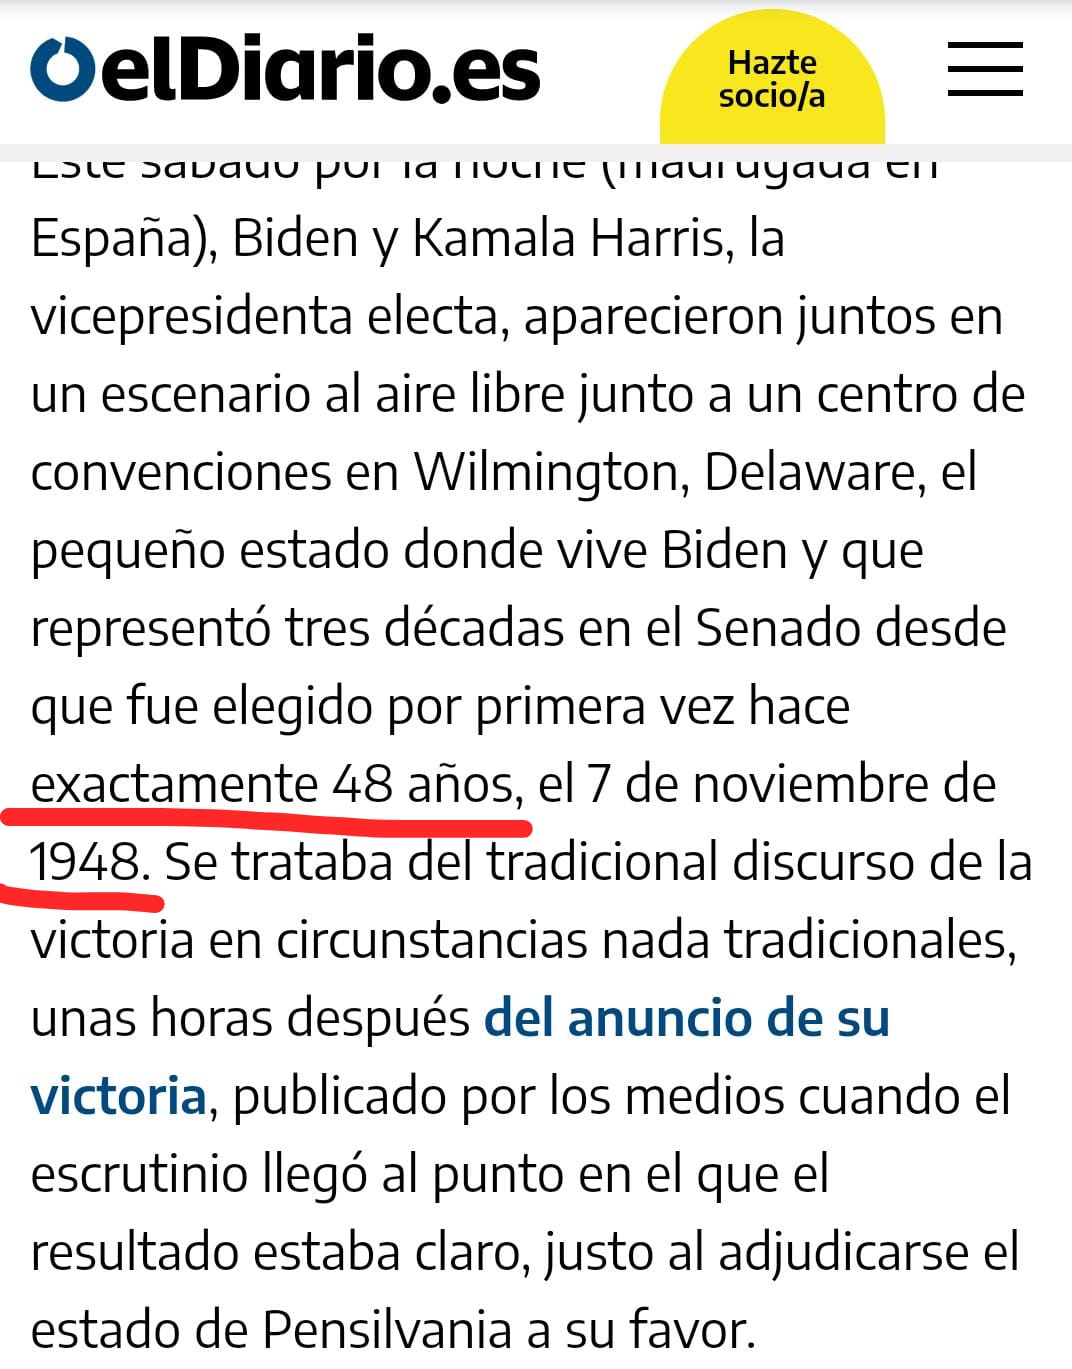
A veces me arrancan, como en este caso, una sonrisa por pensar que si hace exactamente 48 años era el 7 de noviembre de 1948, estamos ahora mismo a 1996, lo que tiene su punto nostálgico, una especie de deseo «vintage» periodístico.

Ya pedir que no haya errores ortográficos o tipográficos parece un ansia por quimeras inasibles.

Dobles negaciones

He perdido otro valioso rato de mi vida leyendo un texto de un médico jubilado que escribía una carta abierta en una red social a algún ministro o cargo sanitario que según él está gestionando muy mal este periodo pandémico o plandémico o como quieran llamarlo. No entro a valorar este tema del que me considero un total ignorante ni quiero perder mi tiempo con estadísticas que no sé contextualizar, ni con informes médicos que no quiero conocer (no tengo el nivel suficiente para comprender).

Pero cuando leo estas frases, pierdo el respeto a quien las firma:

Yo no soy ningún negacionista, al contrario; “Afirmo la falta de evidencias científicas en muchas de las medidas que ustedes llaman sencillas y esenciales”, y niego la existencia de datos irrefutables que las justifiquen”.

He marcado en negritas (o blanquitas) las palabras que me han llamado la atención:

«no soy ningún negacionista»: no puede tener más palabras «negativas». Veamos: «no» y «ningún», ¿Esta doble negación tan característica del idioma español significa en realidad SÍ? En caso de que no sea el caso (jejeje) lo que está diciendo (sin el ningún se entiende mejor) «no soy negacionista».

Y aquí llega lo mejor, «al contrario»: es decir, negando lo anterior…

«afirmo la falta»: lo que vuelve a ser negacionista, aunque use la palabra «afirmo». Afirmar una negación es negar. Menos mal que termina reconociendo que «niega la existencia».

Este señor, aparte de negacionista, es un compendio de malas praxis en la redacción a la búsqueda de ampulosidad que dote a su carta abierta de cierta «credibilidad».

Por supuesto, aparte de negacionista, es casi nihilista… y eso hasta cabría decir que me ha hecho gracia.

Aunque parezca mentira, los virus cometen faltas de ortografía

Una forma sencilla de detectar si un correo electrónico es sospechoso de ser un virus es mediante el análisis de la ortografía del mismo, especialmente si procede (al menos aparentemente) de una fuente como un banco, una operadora telefónica, la administración pública, etc.

Quizá por ello soy minucioso a la hora de redactar correos electrónicos, aunque finalmente no acabe teniendo demasiada incidencia si utilizas, como en nuestro caso, un hosting compartido por motivos de ahorro económico, lo que conlleva que no pueda controlar lo que hacen otras de las instancias instaladas junto al espacio (IP) donde tenemos alojado nuestro servidor de correo electrónico, derivando, nuestro correo, con altísima frecuencia a la carpeta de SPAM.

El lunes recibí este mensaje y pude ignorarlo tan sólo por eso VINCIÓ EL PRAZO sin necesidad de continuar leyendo, ni siquiera atender a que la dirección de origen no corresponde a la de VODAFONE y sin saber que la página al que llevan los enlaces en el correo no corresponden a esa empresa con la que, además, no tengo ninguna relación contractual.

He aquí la cabecera del mensaje, sin adulterar, mostrando mucha más información de la que debería mostrar, pero sabiendo que, en realidad, los problemas derivados de conocerla no son tan graves:

From – Mon Aug 24 10:58:15 2020
X-Account-Key: account4
X-UIDL: UID56194-1266393476
X-Mozilla-Status: 0001
X-Mozilla-Status2: 00000000
X-Mozilla-Keys: $label1
Return-Path:
Delivered-To: clave53@clave53.org
Received: from just2048.justhost.com
by just2048.justhost.com with LMTP
id 6KrJB082Q1+VjwQAXwh+vw
(envelope-from )
for ; Sun, 23 Aug 2020 21:38:55 -0600
Return-path:
Envelope-to: borrarme@clave53.org
Delivery-date: Sun, 23 Aug 2020 21:38:55 -0600
Received: from qwe4.oaberh.com ([45.79.239.176]:40920 helo=localhost.members.linode.com)
by just2048.justhost.com with esmtp (Exim 4.93)
(envelope-from )
id 1kA3Ju-001Hyz-DT
for borrarme@clave53.org; Sun, 23 Aug 2020 21:38:55 -0600
Received: by localhost.members.linode.com (Postfix, from userid 0)
id DD11152605; Mon, 24 Aug 2020 02:52:13 +0000 (UTC)
MIME-Version: 1.0
Content-type: text/html; charset=UTF-8
Content-Transfer-Encoding: base64
Subject: Fwd: factura pendiente
From: Notificacion
To: borrarme@clave53.org
Message-Id: <20200824031407.DD11152605@localhost.members.linode.com>
Date: Mon, 24 Aug 2020 02:52:13 +0000 (UTC)
X-Spam-Status: No, score=3.8
X-Spam-Score: 38
X-Spam-Bar: +++
X-Spam-Flag: NO

Aquí está el contenido del mensaje en el que deparé en esa ortografía tan deficiente que es sinónimo de correo sospechoso:

«ver en el navegador» (enlazado a http://XXXXXXhttp.extrajudicialmbajadas.comXXXXX/judicial, pero sin las XXXX)
Cordial Saludo,

Le recordamos que se vinció el prazo de pagos de su factura con
nosotros, la factura 05105AS8054RAJZ

Lamentamos informarle que si el pago no si realiza hasta 25 de agosto
del 2020 suspenderemos los servicios y pasaremos su cuenta a nuestros
abogados.

Descargar la factura

© 2020 Vodafone España S.A.U.Avda. América 115, 28042 Madrid

Responderle

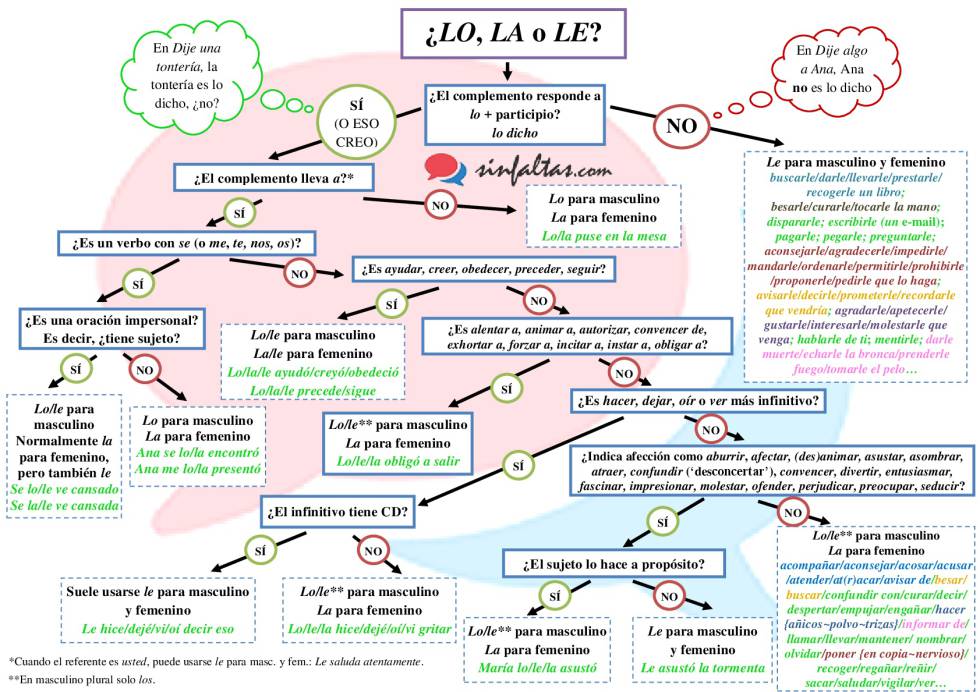
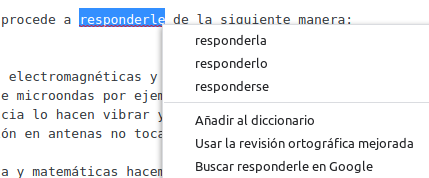
Soy malísimo con el leísmo/laísmo… y suelo dudar más de lo aceptable para alguien que se dedica a las letras, a correcciones ortotipográficas en esta incipiente editorial a la que ahora mismo sólo denomino Gabinete Literario de Clave 53. Así que cuando el autocorrector del ordenador me subrayó mi «responderle» como error y me sugirió cambiarlo por responderla/lo… me encontré con la duda y tuve que acudir a buscarlo en Internet. (Me avergüenza reconocerlo)

Afortunadamente, tal como yo había supuesto, no es complemento directo de la oración (que sería la respuesta dada, no el destinatario de la misma), así que debía ser LE.

Me sentí algo orgulloso de no haberme equivocado esta vez. Pero seguro que no será la última que tenga que recurrir a buscar para aclararme. «shame on me»

¿Nada preocupante o todo lo contrario?

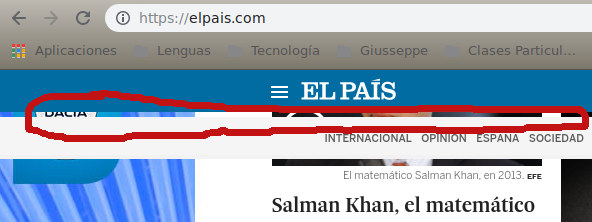
Si yo me hubiese encontrado un problema como ese (lo remarcado en rojo) de posicionamiento de la capa de índice bajo la capa azul, me sentiría avergonzado, yo, que no soy más que un aficionado de la «programación» web, que nunca se debió llamar tal cosa, puesto que es tan sólo un lenguaje interpretado… pero vaya, sin entrar en detalles tontos, ¿nadie se da cuenta de esos píxeles de desajuste o a nadie le importan?

Y aquí mi reflexión:

A casi nadie le importan y quizá a mí me importan demasiado. Es ridículo perder como yo habría perdido, horas en lograr que en cualquier tipo de dispositivo ese posicionamiento ocurriese siempre de manera exacta y sin dejar esa antiestética franja visible… a modo de chapuza. Pero es ridículo, sí, es absurdo. Tanto como todo el contenido junto del periódico en cuestión.

Las faltas de ortografía, gramática y de redacción, sin mencionar los típicos y frecuentes errores numéricos (confundir millones con miles o cosas parecidas) son tan frecuentes en este medio de comunicación que ya ni me preocupo por «hacerlo notar». Así que así seguimos… cada día dándole menos importancia a lo que decimos, a lo que nos dicen, a cómo nos lo dicen… y sin embargo nos atrevemos a llamarlo «información».

Cosas que pasan.

Mientras tanto en otra galaxia…

Diferencias mínimas

¿Pienso que pienso?
vs
¿Pienso qué pienso?

Esa mínima tilde cambia el complemento directo del primer verbo pensar al acto de pensar en el primero de los casos frente a la materia pensada por el segundo verbo pensar en la segunda cuestión.

Texto escrito con 2 palabras, tan sólo «pienso» y «que/qué», usadas de manera que la primera de ellas sea escrita en las cuatro esquinas del texto.

Minudencias…

Esto no es una broma